Thursday, October 18, 2018

Tugas 3 Sistem Keamanan Teknologi Informasi - Resume Bab 7, 8 dan 9

Detail Tugas

Nama: Arya Dwi Pramudita
Kelas: 4KA23
NPM: 11115069
Mata Kuliah: Sistem Keamanan Teknologi Informasi
Dosen: Kurniawan B. Prianto, S.Kom.SH.MM
Nama Tugas: Resume Bab 7, 8 dan 9 Sistem Keamanan Teknologi Informasi

Post ini merupakan tugas ketiga dari mata kuliah Sistem Keamanan Teknologi Informasi (SKTI), yang membahas tentang Pengamanan Jaringan Komputer yang mencakup bab 7, 8 dan 9. Bab 7 memiliki tema dasar yaitu pengamanan terhadap sebuah jaringan komputer (lengkap dengan konsep dasar dari sebuah jaringan komputer itu sendiri), sedangkan bab 8 memfokuskan pembahasannya ke masalah tentang web browser (terutama untuk ancaman yang mengintainya serta pencegahan yang dapat dilakukan terhadap ancaman-ancaman tersebut), dan bab 9 merupakan pembahasan untuk web system (yang tidak lain adalah nama lain untuk aplikasi web). Di bawah ini adalah link untuk mengakses dokumen resume SKTI bab 7 hingga 9:

Terimakasih telah menjadi pembaca setia dari blog ini, semoga resume ini dapat menjadi sumber pengetahuan yang mampu memberikan gambaran bagi para pembaca tentang SKTI serta apa saja yang terkait dengannya.

Thursday, October 11, 2018

Tugas 2 Sistem Keamanan Teknologi Informasi - Resume Bab 4, 5 dan 6

Detail Tugas

Nama: Arya Dwi Pramudita
Kelas: 4KA23
NPM: 11115069
Mata Kuliah: Sistem Keamanan Teknologi Informasi
Dosen: Kurniawan B. Prianto, S.Kom.SH.MM
Nama Tugas: Resume Bab 4, 5 dan 6 Sistem Keamanan Teknologi Informasi

Post ini merupakan tugas kedua dari mata kuliah Sistem Keamanan Teknologi Informasi (SKTI), yang membahas tentang Pengamanan Sistem Operasi, yang dimana pembahasan yang kali ini dilakukan adalah pembahasan tentang bab 4, 5 dan 6. Bab 4 bertemakan tentang pengamanan sistem operasi, sedangkan bab 5 membahas topik tentang malicious software (atau yang dikenal sebagai "perangkat lunak berbahaya"), dan bab 6 difokuskan ke pembahasan tentang pengamanan sistem basis data. Di bawah ini adalah link untuk mengakses dokumen resume SKTI bab 4 hingga 6:

Terimakasih telah menjadi pembaca blog ini, semoga resume ini bisa menjadi bahan bacaan ringan untuk memperluas pengetahuan pembaca tentang SKTI.

Thursday, October 4, 2018

Tugas 1 Sistem Keamanan Teknologi Informasi - Resume Bab 1, 2 dan 3

Preview Cover Depan Resume Bab 1, 2 dan 3

Detail Tugas

Nama: Arya Dwi Pramudita
Kelas: 4KA23
NPM: 11115069
Mata Kuliah: Sistem Keamanan Teknologi Informasi
Dosen: Kurniawan B. Prianto, S.Kom.SH.MM
Nama Tugas: Resume Bab 1, 2 dan 3 Sistem Keamanan Teknologi Informasi

Setelah sekian lama tidak melakukan pembaruan terhadap blog ini (dikarenakan kesibukan penulis yang menyita waktu cukup banyak), penulis ingin membahas tentang Sistem Keamanan Teknologi Informasi (SKTI) yang saat ini dipelajari oleh penulis di semester kali ini (yaitu semester 7).

Umumnya SKTI berkisar pada pembahasan tentang bagaimana seorang pakar teknologi informasi (TI) mengenali dan mengetahui masalah-masalah keamanan yang terjadi pada sebuah sistem TI. Tidak hanya itu, pakar TI juga dituntut untuk mengetahui bagaimana etika yang harus dianut oleh seorang pengguna produk TI, sebagai langkah dalam menciptakan sebuah masyarakat melek TI yang taat kepada etika yang berlaku dalam TI. Hal ini sangatlah penting, mengingat pada saat ini semakin banyak anggota masyarakat yang bersentuhan dengan TI dalam kehidupan sehari-harinya, bahkan hingga ke tahap dimana produk TI telah menjadi bagian dari gaya hidup sehari-hari.

Agar para pembaca blog ini dapat mengetahui seperti apa pembahasan tentang SKTI, penulis telah membuat sebuah bahan bacaan berjenis resume yang dapat diakses dan dibaca oleh para pembaca, kapan saja dan di mana saja. Silakan kunjungi link di bawah ini untuk mengakses dokumen resume tentang SKTI:


Terimakasih telah menjadi pembaca blog ini, semoga resume ini bisa menjadi bahan bacaan ringan untuk memperluas pengetahuan pembaca tentang SKTI.

Friday, December 8, 2017

Metode Pencarian: Blind and Heuristic

Dalam post kali ini penulis akan membahas tentang metode pencarian buta (blind search) dan heuristik (heuristic search).

A. Metode Pencarian Buta

Secara umum metode pencarian buta didefinisikan sebagai sebuah metode pencarian pada sistem berbasis kecerdasan buatan yang didesain untuk tidak memiliki informasi awal pada sistemnya. Sebagai gantinya, metode ini hanya memiliki kemampuan untuk membedakan sebuah tujuan dengan hal-hal lainnya yang bukan bersifat sebagai tujuan. Hal ini dikarenakan sistem hanya bertugas untuk mencari sesuatu di dalam sebuah pohon pencarian, dengan cara yaitu membuka tiap titik (node) yang ada pada tiap tingkatan (level) dari pohon tersebut. Adapun sebuah titik pada pohon pencarian melambangkan sebuah kondisi, dengan sebagian di antara kumpulan titik pada pohon tersebut merupakan tujuan pencarian dari metode pencarian buta tersebut (walaupun terkadang pada pohon tersebut semua titik yang ada tidak berisi titik tujuan pencarian oleh sistem). Sejatinya pohon pencarian merupakan lambang dari area pencarian yang disasar oleh sistem, dimana hal ini untuk mempermudah proses pencarian node tujuan dengan cara menyusunnya menjadi sebuah pohon yang dapat ditelusuri oleh sistem dengan mudah.

Ada beberapa jenis algoritma yang tergolong sebagai bagian dari metode pencarian buta, namun dua di antaranya adalah algoritma untuk metode pencarian buta yang paling banyak dipergunakan, yaitu:

1. Breadth First Search (BFS)
Penggambaran struktur graf pohon untuk algoritma BFS | Sumber: https://en.wikipedia.org/wiki/Breadth-first_search
Konsep paling awal dari algoritma ini pertama kali dikonsepkan oleh Konrad Zuse pada tahun 1945 dalam tesis Ph.Dnya pada bahasa pemrograman Plankalkül (Formal System for Planning) yang dimana pada konsep yang dikemukakan oleh Zuse tersebut algoritma ini ditujukan sebagai sebuah cara untuk menelusuri komponen yang saling terhubung pada sebuah graf. Konsep algoritma ini kemudian disempurnakan oleh Edward F. Moore untuk pencarian jalan paling singkat untuk keluar dari sebuah labirin. Secara sederhana proses pencarian simpul graf dengan menggunakan algoritma BFS menggunakan teknik non-rekursif, dengan proses yang dilakukan yaitu:
  1. Kunjungi simpul paling awal dari graf
  2. Setelahnya kunjungi simpul yang bertetangga dengan simpul paling awal tersebut
  3. Jika ada simpul yang belum dikunjungi dan bertetangga dengan simpul yang sudah dikunjungi, kunjungi simpul tersebut hingga semua simpul telah dikunjungi
Namun apabila graf tersebut berbentuk pohon yang memiliki akar, maka prosesnya menjadi:
  1. Kunjungi simpul akar dari graf
  2. Setelahnya kunjungi simpul cabang yang ada di satu tingkat lebih tinggi dari simpul akar
  3. Jika ada simpul yang belum dikunjungi dan berada di satu tingkat yang lebih tinggi dari tingkatan simpul yang sudah dikunjungi, kunjungi simpul tersebut hingga semua simpul telah dikunjungi
Karena umumnya graf direpresentasikan sebagai sebuah array berbentuk antrian (queue), maka secara umum operasi pengunjungan simpul pada graf dengan menggunakan algoritma BFS dilakukan dengan cara yaitu menelusuri masing-masing elemen data pada array graf tersebut secara keseluruhan. Selain menggunakan array antrian, algoritma BFS juga menggunakan linked list sebagai media penggambaran dari graf yang isinya akan ditelusuri satu per satu untuk mencari simpul tujuan dari graf tersebut. Namun pada dasarnya penggunaan array maupun linked list dalam algoritma BFS sama-sama menggambarkan bahwa operasi dari algoritma tersebut akan menelusuri masing-masing elemen dalam sebuah graf untuk mencapai elemen tujuan tanpa mengetahui elemen apa yang akan dilalui selama mencari jalan tersingkat menuju elemen tujuan tersebut.

Contoh dari pengaplikasian BFS dalam pemecahan suatu masalah yaitu pada kasus pencarian rute angkutan umum dari suatu lokasi ke lokasi lainnya. Pada kasus ini titik awal pencariannya adalah Terminal Senen, dengan titik akhirnya yaitu Terminal Kampung Rambutan. Prosesnya yaitu:
  1. Kunjungi titik Terminal Senen.
  2. Setelahnya bangkitkan simpul cabang dari titik Terminal Senen yaitu Blok M, Pulo Gadung dan Manggarai, lalu kunjungi simpul cabang tersebut.
  3. Karena titik tujuan belum tercapai, maka bangkitkan simpul cabang dari masing-masing simpul cabang yang telah dikunjungi pada tahap nomor 2, yaitu Grogol, Lebak Bulus, Bekasi, Cililitan dan Harmoni.
  4. Dikarenakan titik tujuan masih belum tercapai, bangkitkan simpul cabang dari masing-masing simpul cabang yang telah dikunjungi pada tahap nomor 3 yaitu Kalideres, Ciputat, Kampung Rambutan, Kota dan Tanah Abang.
  5. Pada tahap ini titik tujuan (yaitu Kampung Rambutan) sudah ditemukan, sehingga proses selesai.
Di sini sistem tidak mengetahui isi dari titik cabang untuk Terminal Senen, sehingga sistem akan terlebih dahulu membuka lalu mengunjungi masing-masing titik cabang tersebut dengan menggunakan algoritma BFS untuk mengetahui isi dari titik selanjutnya. Ketika dibuka dan dikunjungi, ternyata isinya adalah Terminal Blok M, Terminal Pulo Gadung dan Terminal Manggarai. Maka di sini sistem akan mengulangi prosesnya untuk mengetahui isi dari titik selanjutnya. Proses ini terus dilakukan hingga akhirnya sistem menemukan salah satu titik cabang dari titik cabang yang telah dikunjungi pada tahap sebelumnya adalah titik tujuannya yaitu Terminal Kampung Rambutan. Kemampuan untuk membedakan titik tujuan dari titik bukan tujuan sangatlah dibutuhkan karena hal ini digunakan untuk mencegah sistem menemui kebuntuan ketika mencari titik tujuan.

2. Depth First Search (DFS)
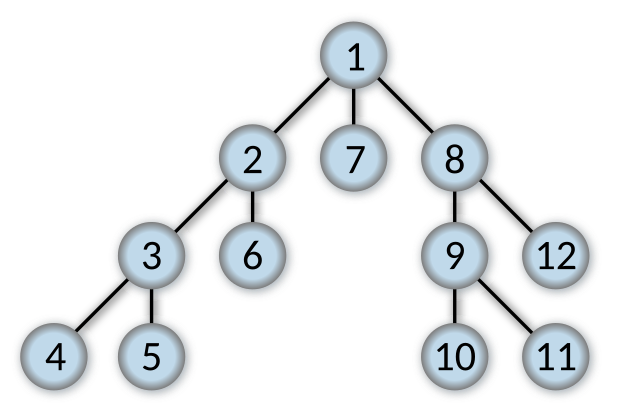
Penggambaran struktur graf pohon untuk algoritma DFS | Sumber: https://en.wikipedia.org/wiki/Depth-first_search
Algoritma ini pada dasarnya memiliki kesamaan struktur dengan algoritma BFS, dimana sistem akan mencari titik tujuan dengan mengunjungi semua titik pada satu tingkat sebelum kemudian beranjak ke tingkat selanjutnya untuk mengunjungi titik lainnya hingga titik tujuannya berhasil ditemukan. Namun perbedaannya adalah algoritma DFS bekerja dengan cara yang terbalik dibanding dengan BFS, dimana algoritma DFS menerapkan prinsip berupa penelusuran dari tingkat pertama langsung ke titik paling kiri dari tingkat selanjutnya. Adapun cara kerjanya yaitu sistem terlebih dahulu mengunjungi titik paling kiri dari tingkat selanjutnya pada graf untuk mencari titik tujuannya. Jika pada posisi tersebut titik tujuannya tidak ditemukan, maka sistem kemudian mencari hingga ke titik paling kiri dari tingkat terdalam. Apabila tidak juga ditemukan, maka penelusuran akan dilakukan dari titik sebelah kanannya. Proses ini dilanjutkan secara berulang hingga titik tujuan ditemukan oleh sistem. Jika titik tujuannya sudah ditemukan, maka proses backtracking yang berfungsi untuk menelusuri balik untuk mendapatkan jalur yang diinginkan tidak perlu dilakukan.

DFS secara umum hanya membutuhkan memori yang sedikit untuk melakukan proses penelusuran sebuah graf secara keseluruhan. Hal ini dikarenakan DFS hanya akan menyimpan titik yang terdapat di lintasan yang aktif saja. Selain itu apabila titik tujuannya berada di posisi paling kiri yang pertama kali ditelusuri maka sistem dapat langsung mengakhiri proses pencariannya tanpa perlu menelusuri titik lainnya dalam graf. Ini tentunya berbeda dengan BFS yang harus menyimpan semua titik yang telah dibangkitkan dan dikunjungi dalam graf, yang dimana ini membebani kinerja memori. Maka dapat dikatakan bahwa algoritma DFS bekerja secara lebih cepat dibandingkan dengan BFS. Namun kelemahannya adalah DFS berpotensi tidak mampu bekerja dengan baik jika berhadapan dengan graf yang jumlah tingkatannya sangat banyak. Bahkan algoritma DFS sendiri juga berpotensi untuk tidak menemukan titik tujuan yang diharapkan.

Contoh pengaplikasian dari algoritma DFS dalam suatu kasus pada dasarnya sama dengan yang ada di algoritma BFS, namun untuk lebih detailnya ada suatu kasus berupa penggunaan algoritma DFS untuk pembuatan aplikasi yang membantu pencarian rute bus terpendek di wilayah kota Solo. Pada kasus ini terdapat banyak bus kota yang beroperasi di dalam wilayah kota Solo, dengan pengoperasian masing-masing trayek dilakukan oleh perusahaan yang berbeda dan rute dari trayeknya berbeda pula. Ini tentunya menyulitkan semua orang yang ingin menggunakan jasa angkutan bus di Solo, sehingga dari sini lahirlah ide pembuatan aplikasi tersebut. Secara singkat pola kerja algoritma DFS pada aplikasi tersebut yaitu mencari rute bus mana yang paling pendek untuk mencapai suatu tempat. Misalkan titik awal pencarian adalah di daerah Palur, sedangkan titik tujuannya yaitu Pasar Klewer. Ada 2 rute bis yang dioperasikan oleh perusahaan yang berbeda, dengan proses penelusurannya yaitu sebagai berikut:
  1. Kunjungi Palur sebagai titik awal pada graf rute.
  2. Selanjutnya bangkitkan dan kunjungi Panggung sebagai titik selanjutnya pada graf tersebut.
  3. Kemudian bangkitkan dan kunjungi Stasiun Solo Balapan sebagai titik selanjutnya. Karena di sini tidak ditemukan titik tujuan yaitu Pasar Klewer, maka proses penelusuran dikembalikan ke titik sebelumnya (Panggung) untuk berpindah ke rute selanjutnya.
  4. Hapus titik Solo Balapan dari memori. Dari Panggung penelusuran diarahkan ke titik yang berada di sisi kanan graf rute yaitu Pasar Gede. Bangkitkan dan kunjungi titik tersebut.
  5. Pada tahap ini bangkitkan dan kunjungi titik selanjutnya. Di sini titik selanjutnya adalah titik tujuan yaitu Pasar Klewer, maka proses penelusuran selesai.

B. Metode Pencarian Heuristik

Metode ini didefinisikan sebagai sebuah teknik pencarian yang didesain untuk menemukan suatu solusi pemecahan masalah secara cepat dan efisien tanpa harus menghabiskan banyak waktu dalam pelaksanaan prosesnya. Umumnya pemecahan masalah yang membutuhkan penggunaan komputer diselesaikan dengan program yang memanfaatkan teknik konvensional seperti pemrograman linear, pemrograman dinamis dan sebagainya. Namun teknik pencarian berbasis heuristik memungkinkan adanya pemecahan terhadap suatu masalah yang tidak dapat diselesaikan dengan teknik konvensional karena berbagai hal yang membuat teknik konvensional tidak dapat memecahkan masalah tersebut, salah satunya seperti tingginya tingkat kerumitan dari masalah tersebut. Meskipun tidak ada jaminan bahwa hasil pencariannya akan sangat lengkap atau optimal sesuai dengan harapan dari pengguna, namun teknik heuristik mampu menghasilkan solusi yang konkrit untuk memecahkan masalah skala besar secara adaptif dan dapat menggunakan modul tambahan dalam mengakses informasi yang berkaitan dengan pemecahan masalah tersebut. Selain itu teknik heuristik biasanya didukung dengan penggunakan antarmuka pengguna yang berbasis grafis (GUI) untuk memudahkan pengguna dalam memahami hasil pencariannya. Bahkan penggunaan teknik heuristik dalam proses pemecahan suatu masalah sendiri memungkinkan didapatnya lebih dari satu solusi untuk memecahkan satu masalah saja, yang dimana ini menandakan teknik heuristik memiliki fleksibilitas yang tinggi.

Seperti halnya metode pencarian buta, terdapat beberapa jenis algoritma dari metode pencarian heuristik. Namun yang akan dibahas dalam artikel ini hanyalah algoritma Generate and Test dan Hill Climbing saja. Pembahasan dari masing-masing algoritma tersebut adalah sebagai berikut:

1. Generate and Test

Secara umum algoritma ini akan melakukan pencarian terhadap suatu solusi dengan memfokuskan pada pencarian solusi yang mungkin untuk dapat dipergunakan dalam memecahkan suatu masalah. Pola dari pencariannya sendiri yaitu membangkitkan suatu kemungkinan solusi (yang pada dasarnya adalah titik dalam suatu graf) untuk kemudian diuji apakah isinya sesuai dengan tujuan yang diharapkan atau tidak. Algoritma ini menjamin ditemukannya solusi yang diharapkan jika prosesnya dilakukan secara sistematis. Tetapi apabila ruang lingkup kerja (graf) yang ditelusuri tersebut sangat luas, maka prosesnya akan membutuhkan waktu yang sangat lama untuk menyelesaikannya. Adapun algoritma ini menggunakan salah satu prinsip dasarnya yaitu dari algoritma Depth-First Search (DFS), dimana prinsipnya dipergunakan untuk proses pembangkitan solusi yang hanya membutuhkan penggunaan memori yang sedikit. Sedangkan untuk proses pengujiannya sendiri menggunakan metode backtracking untuk memastikan apakah solusinya sesuai dengan harapan atau tidak. Secara lengkap pola berikut menggambarkan bagaimana cara kerja dari algoritma Generate and Test ketika mencari solusi (titik tujuan):
  1. Bangkitkan suatu kemungkinan solusi yang ditemukan.
  2. Ujicoba apakah yang telah dibangkitkan adalah benar-benar solusi dengan membandingkan titik yang diuji dengan tujuan yang diharapkan.
  3. Jika yang dibangkitkan merupakan solusi, akhiri proses dan keluar dari sistem. Jika solusi belum ditemukan, ulangi prosesnya ke langkah 1.
Salah satu contoh kasusnya adalah Travelling Salesman Problem (TSP), dimana dalam kasus tersebut diceritakan bahwa seorang salesman ditugaskan untuk mengunjungi beberapa kota sebanyak n. Adapun persyaratan yang ditetapkan adalah sang salesman hanya boleh mengunjungi tiap kota sebanyak sekali, dan yang ingin diketahui adalah rute terpendek yang mampu menghubungkan tiap kota tanpa harus melewati salah satu kota sebanyak dua kali atau lebih. Untuk itu dilakukanlah proses pencarian dengan menggunakan algoritma Generate and Test. Sebagai contoh yaitu ada empat kota yang harus dikunjungi, yaitu kota A, kota B, kota C dan kota D. Jika digambarkan sebagai sebuah graf, maka tiap ruas penghubung masing-masing titik (yang merupakan analogi untuk jarak dari rute antar tiap kota) dalam graf tersebut yaitu:
Graf analogi untuk rute penghubung antar kota | Sumber: http://fryunfirst.blogspot.co.id/2015/06/pencarian-heuristik-heuristic-search.html
Jika ditelusuri dengan menggunakan algoritma ini, maka ada beberapa rute yang memungkinkan untuk diambil pada tiap langkah pencarian, yaitu:
  1. ABCD (jarak: 19) - rute terpilih: ABCD (jarak: 19)
  2. ABDC (jarak: 18) - rute terpilih: ABDC (jarak: 18)
  3. ACBD (jarak: 12) - rute terpilih: ACBD (jarak: 12)
Dari tiap langkah pencarian tersebut dipilihlah rute yang jaraknya paling pendek yaitu ACBD dengan jarak yang harus ditempuh sebanyak 12. Ini dikarenakan berdasarkan pembandingan kemungkinan solusi yang ditemukan dari tiap langkah pencarian tersebut didapat hasil yang menyatakan bahwa dari semua pilihan rute yang ada jarak yang paling pendek untuk ditempuh antara tiap kota adalah rute ACBD. Bila dibandingkan dengan rute lainnya seperti ABCD (19), ABDC (18), ACDB (13) dan sebagainya, rute ACBD inilah yang paling pendek, sehingga ditarik kesimpulan bahwa untuk kasus TSP ini rute yang paling direkomendasikan untuk penyelesaian masalah tersebut adalah rute ACBD, karena rute tersebut memenuhi persyaratan berupa "rute yang diambil haruslah rute terpendek tanpa perlu melewati salah satu kota lebih dari satu kali". Adapun gambar contoh untuk graf pohon yang berfungsi untuk membantu penyelesaian masalah tersebut adalah pada gambar berikut:
Graf pohon untuk penyelesaian kasus TSP | Sumber: https://amandainhere.blogspot.co.id/2016/11/contoh-pencarian-generate-and-test.html

2. Hill Climbing

Berdasarkan strukturnya algoritma ini merupakan variasi dari algoritma Generate and Test yang telah dijelaskan sebelumnya. Karena itulah antara kedua algoritma tersebut terdapat beberapa kesamaan, salah satunya yaitu penggunaan algoritma DFS sebagai basis dasar dari pengembangan algoritma berbasis heuristik. Namun terdapat pula beberapa perbedaan mekanisme yang muncul di antara kedua algoritma tersebut, dengan salah satu perbedaan yang paling mencolok dari algoritma Hill Climbing adalah pada penggunaan teknik heuristik untuk proses pengujian hasil terkaan terhadap suatu titik yang dianalisa oleh sistem. Penggunaan teknik heuristik dalam pengujian hasil terkaan ini adalah dalam rangka untuk menguji seberapa baiknya nilai terkaan yang telah didapat dari hasil pencarian terhadap keadaan yang dibangkitkan dalam proses iterasi yang dilakukan pada algoritma tersebut. Untuk proses pembangkitan dari keadaan berikutnya sendiri semuanya bergantung kepada umpan balik dari prosedur pengujian yang dilakukan pada keadaan sebelumnya.

Pola kerja dari algoritma hill climbing adalah:
  1. Definisikan sebuah keadaan sebagai titik awal.
  2. Terapkan sebuah operasi pada keadaan saat ini dan ambil sebuah keadaan baru sebagai titik berikutnya.
  3. Bandingkan keadaan baru yang telah didapat dengan titik tujuan. Jika titik tujuan telah tercapai, maka akhiri operasi ini. Jika tidak tercapai, maka lakukan langkah 4.
  4. Lakukan evaluasi terhadap keadaan baru tersebut dengan fungsi heuristik, kemudian lakukan pembandingan dengan keadaan yang sekarang. Jika keadaan baru yang dibandingkan tersebut mendekati dengan titik tujuan dibandingkan dengan keadaan yang sekarang, maka perbarui keadaan sekarang tersebut.
Untuk algoritma ini, contoh kasusnya yaitu pada penyusunan isi suatu stack dari yang semula tidak beraturan menjadi terurut, dengan kondisi awal dan kondisi yang dijadikan tujuan adalah seperti pada gambar berikut ini:
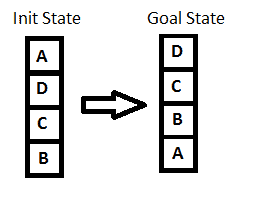
Kondisi awal dan kondisi tujuan dari penyusunan stack | Sumber: http://www.baeldung.com/wp-content/uploads/2017/06/init_goal.png

Proses penyelesaiannya yaitu:
  1. Keluarkan elemen A yang terletak pada posisi paling atas (top) dari stack. Pada posisi ini elemen top berubah dari elemen A menjadi elemen D. Ulangi langkah ini hingga semua elemen telah dikeluarkan dari dalam stack tersebut, dengan elemen B sebagai elemen terakhir yang dikeluarkan dari stack tersebut adalah elemen yang terletak di dasar stack.
  2. Selanjutnya pilih elemen A sebagai elemen dasar baru dari stack, lalu masukkan ke dalam stack. Kemudian pilih B sebagai elemen top dari stack, dan masukkan ke dalam stack. Ulangi prosesnya hingga elemen D (sebagai elemen final) dimasukkan ke dalam stack. Kemudian tetapkan elemen D sebagai elemen top dari stack tersebut.
Apabila dijelaskan berdasarkan gambar maka polanya menjadi:
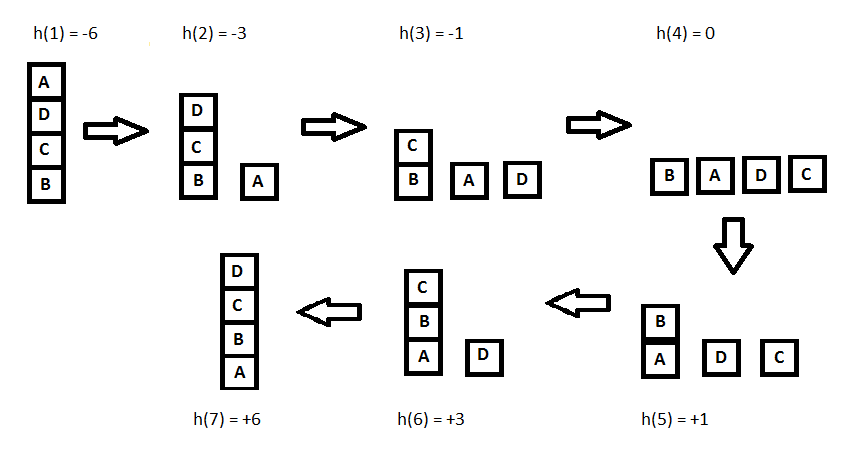
Pola penyelesaian operasi pengurutan data pada stack dengan menggunakan algoritma hill climbing | Sumber: http://www.baeldung.com/wp-content/uploads/2017/06/state_iterations.png
C. Sumber

1. Kendall, Graham. 2001. G5AIAI - Introduction to Artificial Intelligence. http://www.cs.nott.ac.uk/~pszgxk/courses/g5aiai/003blindsearches/blind_searches.htm. 21 November 2017.
2. Novik, Naomi. 1999. Blind Search Algorithms. http://cse.unl.edu/~choueiry/S03-476-876/searchapplet/. 21 November 2017.
3. Anonim. 1998. Blind Search-Part 2. http://web.cs.ucdavis.edu/~vemuri/classes/ecs170/search3b-blind.ppt. 21 November 2017.
4.  Zuse, Konrad. 1972. Der Plankalkül (The Formal System for Planning). http://zuse.zib.de/item/gHI1cNsUuQweHB6. 22 November 2017.
5. Moore, Edward F. 1959. The Shortest Path Through A Maze. Proceedings of the International Symposium on the Theory of Switching. Harvard University Press. pp. 285–292.
6. Wijanarto. Algoritma BFS dan DFS. http://eprints.dinus.ac.id/14269/1/slide_13b.pdf. 22 November 2017.
7. Anonim. 2015. Makalah Algoritma Breadth-First Search (BFS). http://yoursknowladge.blogspot.co.id/2015/04/makalah-algoritma-breadth-first-search.html. 22 November 2017
8. Even, Shimon (2011), Graph Algorithms (2nd ed.), Cambridge University Press, pp. 46–48
9. Herwanto, Arif dan Bambang Eka Purnama. 2013. Penerapan Metode Depth First Search pada Pencarian Rute Bus Kota Berbasis Web Mobile di Solo. Solo: Jurnal Ilmiah Go Infotech. Vol. 19, No. 1: 7-13.
10. Marcoulides, George A. 1998. Modern Methods for Business Research. Psychology Press. pp. 147–173
11. Tru, Cao Hoang. 2009. Heuristic Search - Part 3. http://www.cse.hcmut.edu.vn/~tru/AI/chapter3.pdf. 30 November 2017.
12. Welianto, Selvy dkk. 2011. Implementasi Algoritma Generate and Test Pada Pencarian Rute Terpendek. Yogyakarta: Jurnal Informatika . Vol. 7, No. 2: 1-10.
13. Anonim. 2017. Example of Hill Climbing Algorithm. http://www.baeldung.com/java-hill-climbing-algorithm. 5 Desember 2017.
14. Anonim. 2016. Contoh Pencarian Generate and Test. https://amandainhere.blogspot.co.id/2016/11/contoh-pencarian-generate-and-test.html.  6 Desember 2017.

Saturday, November 18, 2017

Sistem Pakar: Sebuah Pembahasan Singkat

Pada post kali ini, penulis akan membahas tentang sistem pakar (expert system), yang dimana pembahasannya meliputi sejarah singkat dan tujuan dari pembuatan sistem

A. Sejarah Singkat Sistem Pakar

Komputer Symbolics 3640 yang menjadi salah satu platform pengembangan sistem pakar pada masa dahulu kala | Original Author: Michael L. Umbricht and Carl R. Friend (displayed on https://en.wikipedia.org/wiki/Expert_system)
Sistem pakar secara umum dapat dipahami sebagai sebuah sistem yang dibuat untuk dapat mengemulasikan kemampuan pengambilan keputusan dari seorang pakar dalam suatu bidang (terutama ilmu pengetahuan) ke dalam sebuah komputer. Perkembangannya sendiri dimulai sejak era 1970an, dimana pengembangan tahap lebih lanjut dilakukan sejak 1980an. Awalnya sistem pakar dibuat pertama kali oleh Edward Feigenbaum bersama dengan rekan-rekannya yang tergabung dalam Stanford Heuristic Programming Project dalam rangka mengidentifikasi bidang ilmu yang menjunjung tinggi keberadaan pakar yang memiliki keahlian di bidang ilmu tersebut. Meskipun sistem yang dibuat oleh Feigenbaum dan timnya menggunakan prinsip berupa penggunaan kemampuan yang didasarkan pada pengetahuan yang dimiliki dibandingkan dengan mekanisme yang ada pada sistem konvensional, namun sistem tersebut menciptakan sebuah batu loncatan dalam pengembangan sistem pakar di tahun-tahun berikutnya. Adapun sistem pakar sendiri merupakan salah satu bentuk nyata dari perwujudan paling awal untuk konsep kecerdasan buatan (artificial intelligence, AI) pada era tersebut.

Pada saat yang bersamaan, pengembangan sistem pakar juga dilakukan di Perancis. Namun berbeda dengan sistem buatan ilmuwan Amerika yang mengandalkan sistem berbasis aturan (rule-based system) dan menggunakan bahasa pemrograman Lisp sebagai dasar dari pengembangannya, sistem yang dikembangkan di Perancis menggunakan Prolog (dikembangkan pertama kali oleh Alain Colmerauer dan Philippe Roussel pada tahun 1972). Jika keduanya dibandingkan, sistem yang dikembangkan oleh ilmuwan di Perancis memiliki tingkat kesempurnaan yang lebih tinggi dibandingkan konsep sistem pakar yang dikembangkan oleh ilmuwan Amerika. Hal ini dikarenakan prinsip bahasa yang dimiliki oleh Prolog tidak semata berfokus kepada prinsip "if - then" saja, melainkan kepada berbagai pertimbangan-pertimbangan maupun kondisi lainnya. Maka secara umum dapat dikatakan bahwa sistem pakar yang menggunakan Prolog memberikan perwujudan dari logika predikat tingkat pertama (First-order Logic) yang digunakan dalam dunia matematika maupun dunia komputer secara lebih sempurna untuk menyelesaikan masalah-masalah yang membutuhkan keberadaan pakar dari bidang yang bersesuaian dengan masalah tersebut.

Pada era 1980an, kemunculan dari konsep sistem pakar memicu berbagai universitas untuk menawarkan pendidikan yang berkaitan dengan pengembangan sistem pakar kepada mahasiswanya. Bahkan pada saat itu pula perusahaan-perusahaan ikut menerapkan teknologi komputer (termasuk pula sistem pakar) di dalam pola kerja sehari-harinya. Namun pada saat yang sama IBM PC yang dilengkapi dengan sistem operasi IBM PC DOS diperkenalkan pada tahun 1981, yang dimana kemampuan pemrosesannya yang relatif setara dengan mainframe pada saat itu (meskipun ukuran dari chip yang dipergunakan jauh lebih kecil dibandingkan yang ada di mainframe) membuat perkembangan sistem pakar menjadi sangat berubah. Kemunculan dari arsitektur client-server yang bersamaan dengan diperkenalkannya IBM PC membuat perusahaan pengembang sistem pakar memilih untuk mengubah orientasi pengembangan produknya dari yang semula ditujukan untuk lingkungan sistem mainframe berbasis Lisp ke sistem yang berbasis PC. Meskipun begitu, pada tahun 1982 sebuah program sistem pakar berbasis Lisp yang bernama SID (Synthesis of Integral Design) berhasil dikembangkan, dimana ujicobanya dilakukan pada komputer VAX 9000 buatan Digital Equipment Corporation (DEC). Sayangnya, kesuksesan itu tidak bertahan lama karena program tersebut dihentikan pasca selesainya proyek ujicoba sistem tersebut sebagai akibat dari rumitnya struktur program SID. Bahkan istilah sistem pakar (bersama dengan konsep AI yang dapat berdiri sendiri) kemudian tidak lagi dipergunakan di dalam kamus bahasa dunia IT sejak era 1990an dikarenakan pengembang sistem pakar kemudian memilih untuk mengubah konsep pengembangan sistem pakar menjadi pengembangan komponen berbasis pengetahuan untuk program-program standar, seiring dengan semakin pesatnya perkembangan komputer kelas PC dan juga komputer server yang dapat dijangkau oleh perusahaan dengan harga yang lebih murah ketimbang komputer mainframe pada saat itu.

B. Tujuan, Cara Merancang dan Basis Dasar Sistem Pakar

Struktur dasar dari sistem pakar | Original: pubs.cs.uct.ac.za
Sebuah sistem pakar dibuat dengan tujuan yaitu untuk membantu pengalihan sebuah keahlian atau ilmu pengetahuan dari seorang pakar yang menguasai bidang keahlian atau ilmu tersebut ke mereka yang bukan ahlinya. Hal ini dalam rangka untuk menjaga agar keahlian atau ilmu yang disimpan di dalam sistem tersebut dapat terjaga dan terus dapat diturunkan dari generasi ke generasi. Definisi dari pakar sendiri yaitu seseorang yang mampu memberikan penjelasan tentang berbagai hal yang berkaitan dengan suatu masalah maupun mempelajari hal-hal baru seputar topik masalah tersebut, serta menyusun sebuah pengetahuan yang baru (jika kondisinya diperlukan untuk menyelesaikan masalah). Adapun suatu pengetahuan yang disimpan di dalam sistem pakar disebut sebagai basis pengetahuan, dimana basis pengetahuan tersebut terdiri dari fakta dan aturan. Dalam merancang sebuah sistem pakar, tahapan-tahapan yang harus dilalui adalah sebagai berikut:
  1. Mengidentifikasi masalah dan kebutuhan
  2. Menentukan problema yang cocok
  3. Menentukan alternatif pilihan sistem
  4. Menghitung pengembalian biaya investasi pembuatan sistem pakar
  5. Memilih alat untuk pengembangan sistem pakar
  6. Merekayasa pengetahuan
  7. Merancang dasar dari sistem
  8. Melengkapi pengembangan sistem
  9. Menguji, mencari dan memperbaiki kesalahan pada sistem
  10. Memelihara sistem secara keseluruhan
Berbagai tahapan di atas sangat menentukan kesuksesan dari sistem pakar yang dibuat, karena apabila salah satu tahap terlewatkan maka sistem pakar tersebut tidak akan dapat bekerja dengan baik. Bahkan apabila tahap paling awal yaitu mengidentifikasi masalah dan kebutuhan tidak dilalui dengan baik (misalkan masalah yang telah dikaji ternyata tidak cocok untuk diselesaikan dengan bantuan sistem pakar), sebuah sistem pakar tidak dapat dibuat sama sekali. Oleh karenanya dalam proses merancang sistem pakar kesepuluh tahapan tersebut harus dilalui agar sistem pakar yang dirancang dapat bekerja secara maksimal. Terutama ketika menghitung pengembalian biaya investasi pembuatan sistem pakar hingga ke merekayasa pengetahuan, dibutuhkan ketelitian dan kehati-hatian yang sangat tinggi saat melakukan eksekusi dari tahap-tahap tersebut. Hal ini demi mewujudkan sebuah sistem pakar yang berfungsi secara maksimal dan juga bermanfaat bagi penggunanya, tanpa menghasilkan masalah baru di belakang hari.

Sebuah sistem pakar pada dasarnya memiliki dua jenis basis pengetahuan, yaitu:
  1. Penalaran berbasis aturan - di sini sistem dibuat untuk melakukan penalaran terhadap suatu hal dengan berdasarkan aturan yang telah dibuat. Aturannya sendiri berbentuk If - Then, yang dimana ketika dijalankan sistem akan terlebih dahulu memeriksa apakah fakta yang ada sudah sesuai dengan aturan tersebut atau tidak. Jika sesuai, maka sistem akan menampilkan hasil yang menyatakan bahwa fakta yang dimasukkan adalah benar. Namun jika tidak sesuai, sistem akan menampilkan hasil berupa pesan bahwa faktat tersebut salah. Adapun basis pengetahuan jenis ini dibuat jika terdapat beberapa pengetahuan pakar yang dijadikan acuan dalam penyelesaian suatu masalah, dan juga apabila dibutuhkan langkah-langkah yang berkaitan dengan penjelasan tentang pencapaian solusi terhadap masalah yang diselesaikan dengan sistem pakar tersebut.
  2. Penalaran berbasis kasus - untuk jenis ini solusi yang diisikan ke dalam basis pengetahuan dari sistem pakar adalah semua solusi yang telah dicapai sebelumnya untuk kemudian diturunkan menjadi sebuah solusi baru yang relevan dengan fakta yang sedang dikonsultasikan ke sistem pakar tersebut. Biasanya basis pengetahuan yang didasarkan pada penalaran berbasis kasus dibutuhkan ketika pengguna menginginkan adanya perbandingan antara fakta yang sedang dikonsultasikan dengan fakta-fakta lain yang memiliki kemiripan dengan fakta tersebut. Selain itu, bentuk ini juga dipergunakan jika sudah ada contoh situasi atau fakta tertentu yang telah dimasukkan di dalam basis pengetahuan tersebut.
Maka dapat dikatakan bahwa pola kerja dari sebuah sistem pakar dalam menyelesaikan masalah yang dikonsultasikan ke sistem tersebut bergantung dari jenis basis pengetahuan yang dipergunakan dalam menyusun sistem pakar tersebut. Tentunya basis pengetahuan sendiri berisi pengetahuan-pengetahuan yang dibutuhkan dalam menyelesaikan sebuah masalah, dan apa yang dimasukkan ke dalam basis pengetahuan tersebut menentukan bagaimana hasil dari proses penyelesaian masalah yang sedang dikonsultasikan ke sistem pakar tersebut.

C. Contoh Penerapan Sistem Pakar

Tampilan SWI-Prolog
Salah satu contoh paling sederhana dari program sistem pakar yang dapat ditemui dan dipergunakan oleh pengguna awam secara gratis yaitu program SWI-Prolog (SWI merupakan akronim dari Sociaal-Wetenschappelijke Informatica atau bahasa Inggrisnya yaitu Social Science Informatics). Program ini dirancang dan dibuat dengan menggunakan bahasa pemrograman Prolog yang telah teruji sebagai salah satu bahasa pemrograman yang mudah dipergunakan dalam membangun sebuah sistem kecerdasan buatan (Artificial Intelligence / AI). Secara umum pola kerja dari SWI-Prolog mengikuti teknik dasar dari Prolog itu sendiri, dimana program sistem pakar yang dirancang dengan menggunakan SWI-Prolog akan dieksekusi dengan cara menjalankan query di atas hubungan-hubungan fakta dan aturan yang telah didefinisikan di dalam program tersebut. Adapun SWI-Prolog sendiri juga dapat dipergunakan untuk membangun sebuah aplikasi berbasis web yang menggunakan web framework berbasis definition clause grammar. Ini memungkinkan seorang pengembang sistem pakar untuk dapat membangun sebuah sistem pakar yang berbasis online dan juga dapat diakses oleh siapapun, dimana saja dan kapan saja.

Selain itu sistem pakar juga semakin banyak dipergunakan pada tingkat yang lebih luas. Salah satunya yaitu pada perpustakaan, dimana sejak tahun 2004 akhir mulai banyak perpustakaan yang menggunakan sistem pakar untuk membantu pengunjung perpustakaan dalam mencari buku yang ingin dibaca tanpa harus menyebutkan judulnya secara lengkap, yang dimana sistem akan mencari judul buku yang memiliki kata-kata yang cocok dengan input pencarian yang diberikan oleh pengunjung perpustakaan. Penggunaan sistem pakar untuk perpustakaan sendiri tidak hanya ditemukan di Indonesia saja, namun penggunaan sistem pakar untuk perpustakaan juga marak di berbagai perpustakaan yang ada di seantero dunia. Hal ini disebabkan oleh prinsip logika yang dimiliki oleh sistem pakar yang memungkinkan adanya pemberian output berupa suatu solusi meskipun data yang dimasukkan sebagai input untuk proses pencarian solusinya sendiri tidaklah lenglap. Maka dapat dikatakan bahwa sistem pakar memberi kemudahan dalam mencari dan mendapatkan solusi dari suatu masalah dengan menggunakan pengetahuan yang tertanam di dalamnya.

D. Sumber:

1. Magdalena, Merry. 2005. Kecerdasan Buatan Kini Hadir di Perpustakaan. http://lipi.go.id/berita/kecerdasan-buatan-kini-hadir-di-perpustakaan/731. 2 November 2017.
2. Jackson, Peter (1998), Introduction To Expert Systems (3 ed.), Addison Wesley, p. 2, ISBN 978-0-201-87686-4
3. Russell, Stuart; Norvig, Peter (1995). Artificial Intelligence: A Modern Approach. Simon & Schuster. pp. 22–23. ISBN 0-13-103805-2.
4. University of Missouri-St.Louis. Expert Systems and Applied Artificial Intelligence. 2 November 2017. http://www.umsl.edu/~joshik/msis480/chapt11.htm
5. Carl S. Gibson, et al, VAX 9000 SERIES, Digital Technical Journal of Digital Equipment Corporation, Volume 2, Number 4, Fall 1990, pp118-129.
6. Leondes, Cornelius T. (2002). Expert systems: the technology of knowledge management and decision making for the 21st century. pp. 1–22. ISBN 978-0-12-443880-4.
7. Durkin, J. Expert Systems: Catalog of Applications. Intelligent Computer Systems, Inc., Akron, OH, 1993.
8. A. Michiels. Introduction A Prolog: Et Au Traitement Du Langage Naturel. http://promethee.philo.ulg.ac.be/engdep1/download/prolog/htm_docs/prolog.htm. 3 November 2017
9. Kowalski, R. A. (1988). "The early years of logic programming". Communications of the ACM. 31: 38.
10. Colmerauer, A.; Roussel, P. (1993). "The birth of Prolog". ACM SIGPLAN Notices. 28 (3): 37.

11. Orfali, Robert (1996). The Essential Client/Server Survival Guide. New York: Wiley Computer Publishing. pp. 1–10. ISBN 0-471-15325-7.
12. Dahria, Muhammad. 2011. Pengembangan Sistem Pakar Dalam Membangun Suatu Aplikasi. https://lppm.trigunadharma.ac.id/public/fileJurnal/hp633-Jurnal-DAR-Sistem%20Pakar.pdf. 5 November 2017.
13. Clocksin, William F.; Mellish, Christopher S. (2003). Programming in Prolog. Berlin ; New York: Springer-Verlag.
14. Ogborn, Anne. 2015. "Tutorial — Creating Web Applications in SWI-Prolog". http://www.pathwayslms.com/swipltuts/html/index.html. 8 November 2017
15.  Lloyd, J. W. (1984). Foundations of Logic Programming. Berlin: Springer-Verlag.

Sunday, October 29, 2017

Tugas Grafik Komputer dan Pengolahan Citra: Membuat Garis Menggunakan Java dan OpenGL


Pada kesempatan kali ini penulis membuat sebuah tugas yang dimana tugasnya yaitu membuat sebuah program sederhana yang dapat menggambar garis horizontal, vertikal dan diagonal dengan berdasarkan input titik awal garis dan titik akhir garis dari pengguna, dimana program ini memanfaatkan library grafis OpenGL sebagai library untuk menampilkan outputnya di layar monitor. Bahasa pemrograman yang dipergunakan yaitu Java, dengan pembuatannya menggunakan program NetBeans versi 8.2. Adapun untuk library penghubung yang dipergunakan dalam menghubungkan Java dan OpenGL pada program ini yaitu LWJGL (LightWeight Java Game Library) versi 2.9.1.

Program ini dibuat dengan menggunakan empat file kelas Java, yaitu:
  1. Pr_Main.java - file kelas utama yang menampilkan menu utama program.
  2. Pr_Horizontal.java - file kelas yang berfungsi untuk menerima input dan menampilkan output garis horizontal (garis mendatar).
  3. Pr_Vertikal.java - file kelas yang berfungsi untuk menerima input dan menampilkan output garis vertikal (garis tegak lurus).
  4. Pr_Diagonal.java - file kelas yang berfungsi untuk menerima input dan menampilkan output garis diagonal (garis miring).
Seperti yang telah disebutkan di awal, program ini menggambar garis dengan berdasarkan titik awal dan titik akhir garis yang dimasukkan oleh pengguna. Maka dari sini dapat dikatakan bahwa program tersebut harus menggambar garis di layar dari suatu titik ke titik lain secara jelas dengan berdasarkan permintaan dari pengguna (dalam hal ini yaitu input titik awal dan titik akhir garis dari pengguna).

Di bawah ini adalah link untuk mengunduh program dan source code serta file dokumentasinya:
  1. Program + Source Code: klik di sini
  2. Dokumentasi + User Guide: klik di sini
Sekian dan terima kasih atas kunjungannya ke blog ini!

Saturday, October 21, 2017

PEAS: Sebuah Definisi

Kategori: Tulisan

Dalam tulisan kali ini akan dijelaskan tentang definisi dari pola PEAS yang dipergunakan dalam intelligent agent.

A. Definisi

PEAS merupakan sebuah pola pendeskripsian lingkungan kerja dari intelligent agent yang berfungsi untuk menjelaskan berbagai parameter yang tepat dalam mendefinisikan intelligent agent. Istilah ini merupakan kependekan dari Performance, Environment, Actuators dan Sensors, dimana keempat hal ini secara harafiah dijelaskan sebagai kumpulan parameter masalah yang diperlukan dalam proses pendefinisian dari suatu intelligent agent yang dapat menyelesaikan masalah-masalah tersebut.

Dalam praktiknya, PEAS dijadikan sebagai model utama dalam menentukan pendefinisian sebuah rational agent yang ideal. Hal ini dikarenakan apa yang dijabarkan dalam pola PEAS mencakup poin-poin penting dari sebuah masalah yang harus diselesaikan oleh agent tersebut secara rasional dan juga proporsional. Maka dari sini dapat dikatakan bahwa agent akan menyelesaikan semua permasalahan yang ditemui berdasarkan pada poin permasalahan yang ditentukan menggunakan parameter dari PEAS, sehingga masalah-masalah yang ditemui dapat diselesaikan secara baik.

Secara dasar, PEAS sendiri dapat dijelaskan menjadi seperti berikut:
  1. Performance: di sini kinerja agent menjadi tolok ukur penentu dari derajat kesuksesan sebuah proses penyelesaian masalah.
  2. Environment: menentukan lingkungan yang dijadikan sebagai sasaran dari proses penyelesaian masalah oleh sang agent.
  3. Actuators: perangkat yang digunakan agent untuk menyalurkan usahanya sangat menentukan seberapa besar usaha yang dibutuhkan dalam memecahkan masalah.
  4. Sensors: agent akan menentukan solusi yang dibutuhkan untuk memecahkan suatu masalah dengan berdasarkan apa yang ditangkap oleh sensor yang dimiliki agent tersebut.
Keempat poin di atas apabila dicontohkan pengaplikasiannya maka dapat seperti berikut ini (dengan contoh agent yaitu sistem diagnosa medis):
  1. Performance: kesembuhan pasien pasca pengobatan, biaya perawatan yang minim dan sengketa dalam proses pengobatan
  2. Environment: pasien, rumah sakit dan dokter
  3. Actuators: layar monitor untuk komunikasi
  4. Sensors: keyboard
Maka di sini dapat dikatakan bahwa penggunaan prinsip PEAS sebagai sebuah metode dalam mendefinisikan intelligent agent sangatlah berguna untuk menentukan ketepatan dan keefektifan kinerja dari agent secara baik.

B. Sumber

http://www4.ncsu.edu/~stamant/411/lectures/02-agents/peas.pdf
https://www.tutorialspoint.com/artificial_intelligence/artificial_intelligence_agents_and_environments.htm
http://www.cs.csi.cuny.edu/~imberman/ai/Intelligent%20Agents.pdf
https://web.northeastern.edu/magy/courses/AI/lectures/IA.pdf
http://maukar.staff.gunadarma.ac.id/Downloads/files/42871/Agent.pdf
Russell, Stuart J.; Norvig, Peter (2003), Artificial Intelligence: A Modern Approach (2nd ed.), Upper Saddle River, New Jersey: Prentice Hall, ISBN 0-13-790395-2, chpt. 2